模型与用量
Hetu 不内置模型,只做协议适配与场景编排:你提供供应商与 Key,它负责把能力分配到场景,并记录每次调用的用量。
供应商与模型
| 项 | 说明 |
|---|
| 协议 | OpenAI 兼容(含 Ollama / LM Studio / vLLM 等本地服务)与 Anthropic |
| 连接信息 | Base URL + API Key;Key 用 DataProtection 加密落库 |
| 模型用途 | chat(对话与 Agent 循环)/ embedding(索引与检索)/ completion(轻量改写) |
| 模型标识 | 请求时使用的模型 ID,需与供应商侧一致 |
按场景指定默认模型
| 场景 | 典型选择 |
|---|
| 对话 / 编码会话 | 推理能力最强的模型 |
| Wiki 生成 / 图谱抽取 | 中等模型即可,重视长文本处理 |
| 话题整理 / 压缩摘要 | 便宜快速的小模型 |
| 笔记 AI / 查询改写 | 低延迟小模型 |
| Embedding | 维度与 Embedding:Dimensions 一致的向量模型 |
代理服务
入口:/proxy。把已配置的模型暴露成本地兼容接口,供编辑器、CLI、脚本使用同一批 Key 与同一份用量统计。
# OpenAI 兼容入口
Base URL: http://localhost:5000/api/proxy/openai/v1
API Key : 在「代理服务」页面生成

# Anthropic 兼容入口
Base URL: http://localhost:5000/api/proxy/anthropic
| 能力 | 说明 |
|---|
| 路由 | 控制在接口中对外可见的模型列表 |
| 影子模型 | 同一请求额外打给另一个模型,用于对比输出 |
| 用量归属 | 经代理的调用同样计入用量统计(来源标记为 proxy) |
代理调用示例
# 列出对外可见的模型
curl http://localhost:5000/api/proxy/openai/v1/models \
  -H "Authorization: Bearer <本机代理 Key>"

# 走代理发起一次对话
curl http://localhost:5000/api/proxy/openai/v1/chat/completions \
  -H "Authorization: Bearer <本机代理 Key>" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-4o-mini","messages":[{"role":"user","content":"hi"}]}'
经代理的调用会带上来源标记 proxy 进入用量统计;模型可见性与影子模型在「代理服务」页配置。
供应商与模型字段
| 层级 | 字段 |
|---|
| 供应商 | 名称、协议(OpenAI 兼容 / Anthropic)、Base URL、API Key(加密存储)、是否启用 |
| 模型 | ModelId(请求时原样发送)、显示名、用途(chat / embedding / completion)、是否该用途默认、上下文长度等元信息 |
| 压缩管道 | 触发阈值、目标长度、摘要模型;压缩前后 Token 都记入用量 |
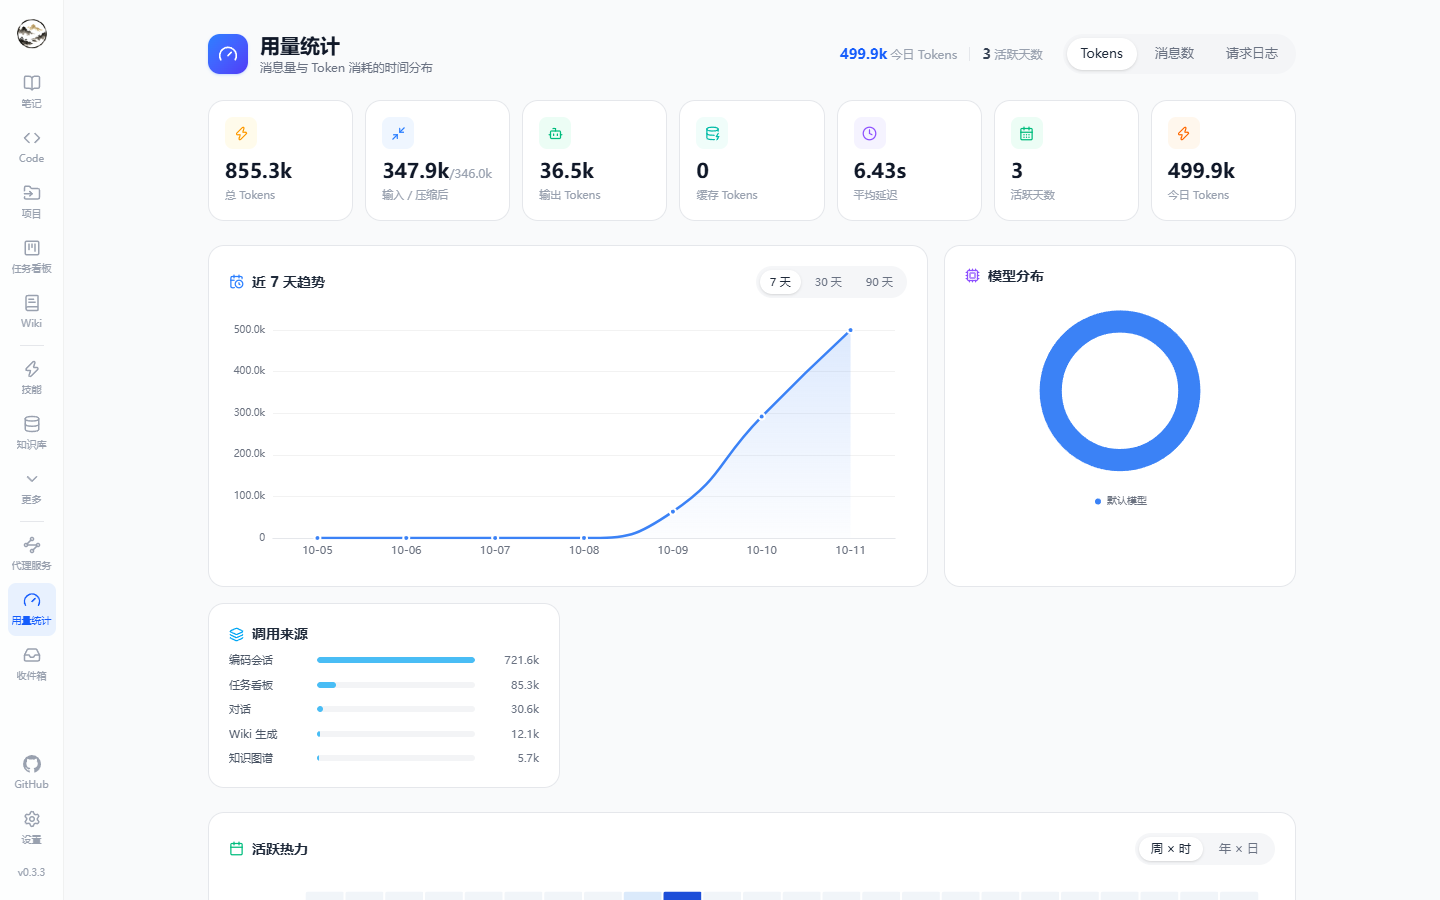
用量与成本
| 指标 | 说明 |
|---|
| 概览 | 总消息数、输入 / 压缩后 / 输出 / 缓存 Token、平均延迟、活跃天数、今日用量 |
| 趋势 | 近 7 / 30 / 90 天曲线;周×时与年×日热力图 |
| 分布 | 按模型、按来源(对话 / 编码会话 / 看板 / Wiki / 图谱 / 定时任务 / 代理…) |
| 明细 | 分页日志:时间、模型、各段 Token、延迟、来源、内容摘要;可按来源与业务引用过滤 |
压缩管道
入口:设置 → 成本控制。长会话不可能无限塞进上下文,压缩管道负责在阈值处做摘要式压缩。
| 参数 | 说明 |
|---|
| 触发阈值 | 上下文占用达到多大比例时触发 |
| 目标长度 | 压缩后保留多少内容 |
| 摘要模型 | 用哪个模型做摘要(可指定,未指定时回落默认对话模型) |
| 统计 | 压缩前后的 Token 都记入用量,便于评估节省效果 |
省 Token 的一些做法
| 做法 | 原因 |
|---|
| 索引、整理、打标签用便宜模型 | 这类任务量大但不依赖强推理 |
| 只在需要时打开知识库 / 记忆开关 | 避免每次请求都注入检索结果 |
| Code 会话用独立工作树并明确任务边界 | 减少来回试错轮次 |
| 长任务用 Autopilot、短问答用交互式 | 前者省确认轮次,后者省无用工具调用 |