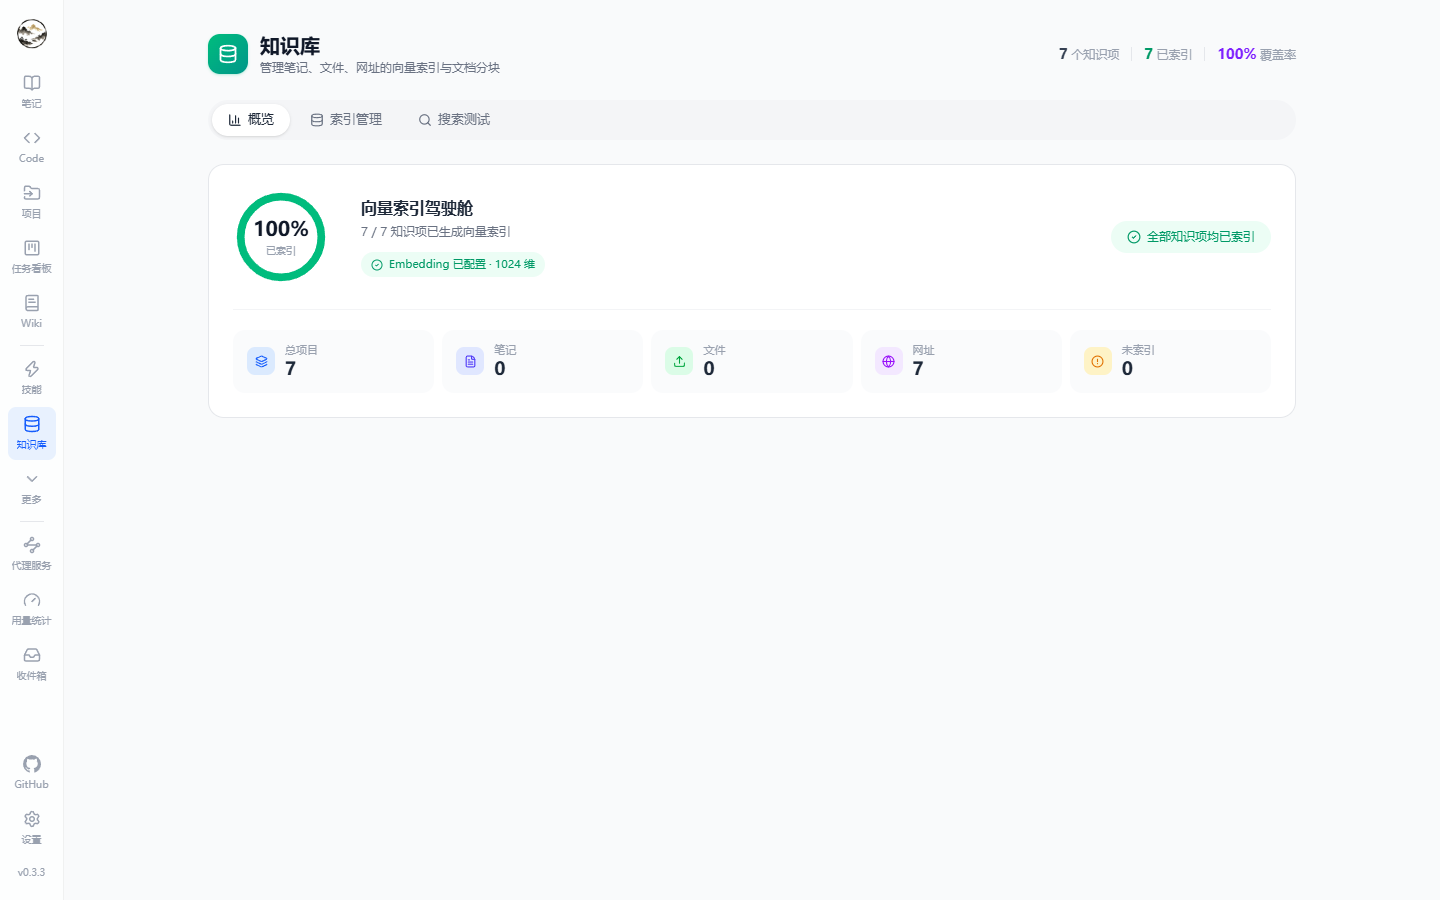
知识库
把笔记、文件、网址统一分块并生成向量,供对话检索与语义搜索使用。入口:左侧导航「知识库」(路由 /knowledge-base)。
索引管线与检索出口:分块 → 向量化 → 写向量表与元数据;对话、搜索测试、Wiki 与模型工具都从同一份向量里召回。
三种来源
| 来源 | 添加方式 | 说明 |
|---|
| 笔记 | 编辑器顶部「生成索引」,或知识库批量补索引 | 按 Markdown 结构分块 |
| 文件 | 知识库页上传 | 记录文件名、大小、MIME,正文抽取后分块 |
| 网址 | 知识库页填入 URL | 抓取网页正文(含标题)后分块 |
索引管线
- 分块:按结构切分内容,每块记录序号、分块方式与内容。
- 向量化:调用
embedding 用途的模型生成向量,写入向量表(SQLite 用 sqlite-vec 的 vec0 虚拟表;PostgreSQL 用 pgvector 列)。
- 记录元数据:每块保存模型名与维度,供状态页展示与校验。
- 任务化:整个过程是后台任务(类型
GenerateEmbedding / GenerateKnowledgeItemEmbedding),可在「后台任务」页看到耗时与失败原因。
三个页签
| 页签 | 内容 |
|---|
| 概览 | 知识项总数、已索引数、覆盖率、向量维度、按类型(笔记 / 文件 / 网址)分布、运行中任务数 |
| 索引管理 | 逐项状态:分块数、模型、维度、最近索引时间、是否有运行中任务;单项重新索引与「批量生成索引」(只处理未索引项) |
| 搜索测试 | 输入查询直接看向量召回结果,可调 Top-K,命中片段高亮——用来验证索引质量 |
索引相关字段
| 表 | 字段 |
|---|
KnowledgeItems | Type(Note / File / Url)、Title、Content、SourceUrl、FileName、FileSize、MimeType、NoteId、IsDeleted |
NoteChunks | KnowledgeItemId、ChunkIndex、ChunkMethod、Content、Summary |
NoteChunkEmbeddings | ChunkId、Model、Dimensions、UpdatedAt、Embedding(SQLite 侧向量在 vec_chunk_embeddings) |
状态接口返回 totalItems / indexedItems / unindexedItems / noteCount / fileCount / urlCount / hasEmbeddingProvider / dimensions / runningTaskCount;索引列表每项含 chunkCount、embeddingModel、embeddingDimensions、embeddingUpdatedAt、hasRunningTask。
检索如何被使用
- 对话输入框的「知识库」开关:召回结果作为上下文注入,并在界面给出命中列表。
- 模型也可通过工具主动检索(笔记搜索、知识库检索),由权限模式与工具白名单约束。
- Wiki 生成时可叠加语义检索,从项目资料里挑相关内容。
配置与限制
| 项 | 说明 |
|---|
Embedding:Dimensions | 向量维度,默认 1536;必须与模型实际维度一致,否则 SQLite 侧写入会失败 |
| 换模型 | 换 Embedding 模型后需重新索引(旧向量维度不匹配) |
| Anthropic | 无公开 Embedding 接口,需用 OpenAI 兼容供应商 |
| 删除语义 | 笔记进回收站只软删知识项,分块与向量保留,恢复后仍是已索引状态 |
性能相关
- 状态统计在数据库侧聚合(按类型
GROUP BY、DISTINCT 计数、按知识项分组的分块摘要),不把全部向量元数据读进内存。
- 页面只在「存在未索引项或有运行中任务」时轮询,状态接口带短时响应缓存。